 / blog
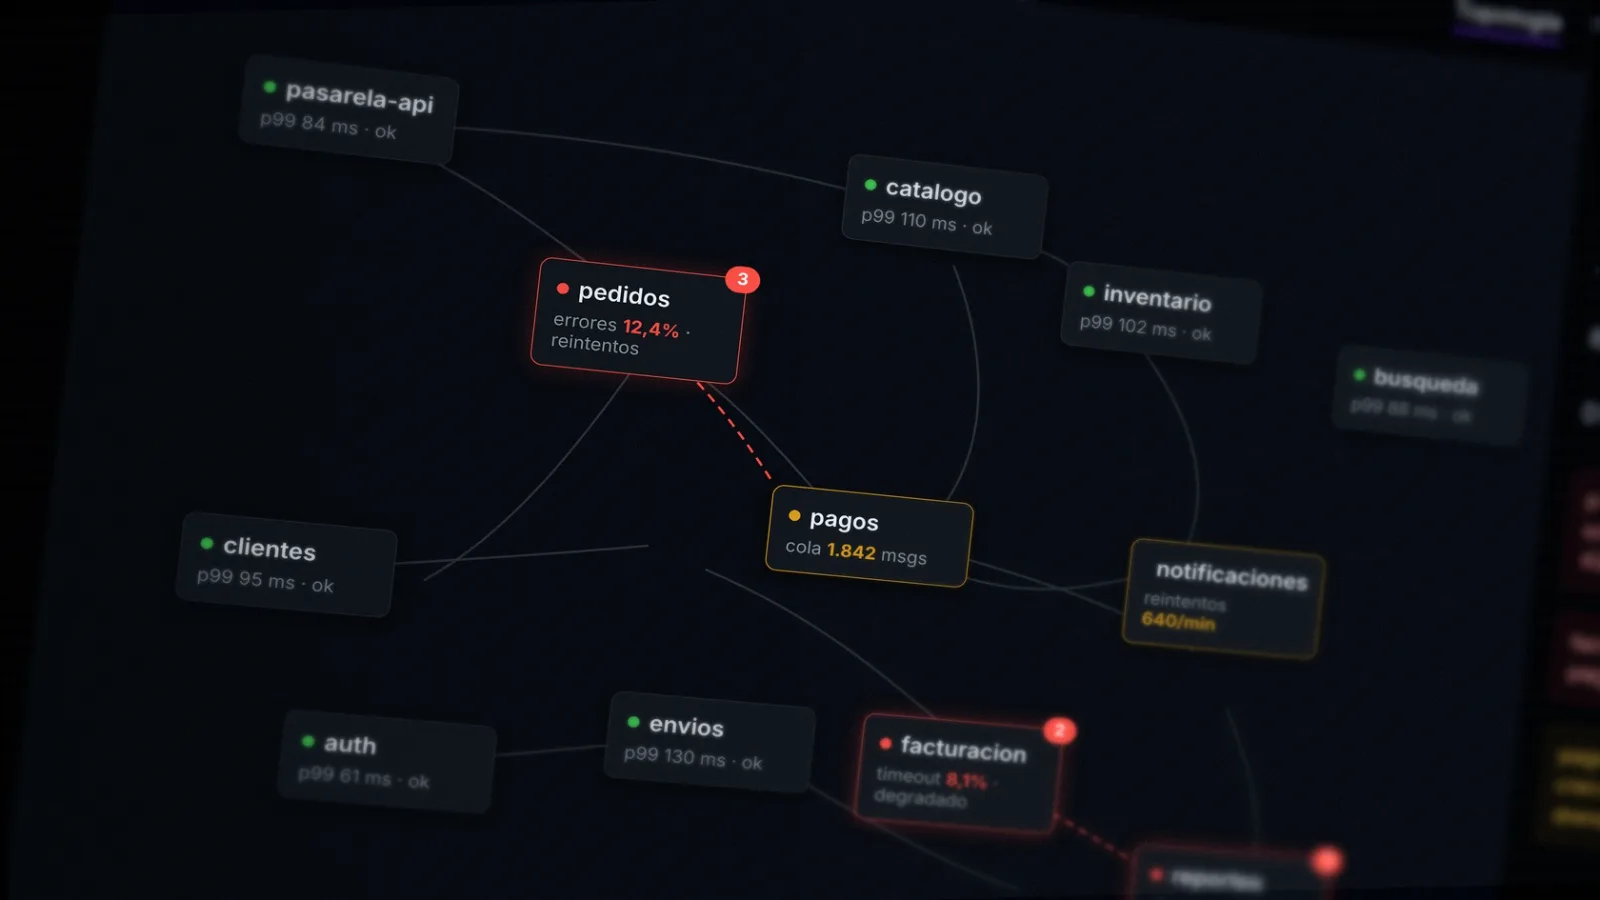
Los microservicios se convirtieron en la respuesta por defecto cuando una empresa planea un sistema nuevo, propuestos por los proveedores en las licitaciones y pedidos por los desarrolladores en las entrevistas, con la reputación de ser lo que usan las compañías tecnológicas grandes. La reputación es merecida en su contexto original, y ese contexto es el punto que suele perderse en la decisión: el patrón resuelve problemas de coordinación que aparecen con decenas de equipos trabajando sobre el mismo sistema, y cobra unos costos operativos fijos que existen desde el primer servicio, tenga la empresa el tamaño que tenga.
Los problemas que los microservicios resuelven
La arquitectura de microservicios nació en organizaciones donde cientos de desarrolladores compartían una sola base de código y cada despliegue requería coordinar equipos que no se conocían entre sí. Partir el sistema en servicios independientes les devolvió a esos equipos la capacidad de desplegar sin pedir permiso, de escalar solo el componente saturado, de elegir tecnologías distintas donde se justificaba y de contener una falla sin tumbar el resto.
Cada uno de esos beneficios responde a un problema organizacional medible, como los equipos que se bloquean entre sí, los componentes con demandas de carga muy distintas o los dominios del negocio que evolucionan a ritmos diferentes. En una empresa donde un solo equipo de cinco u ocho personas construye y opera el sistema completo, esos problemas todavía no existen, y una arquitectura diseñada para resolverlos solo puede aportar sus costos.
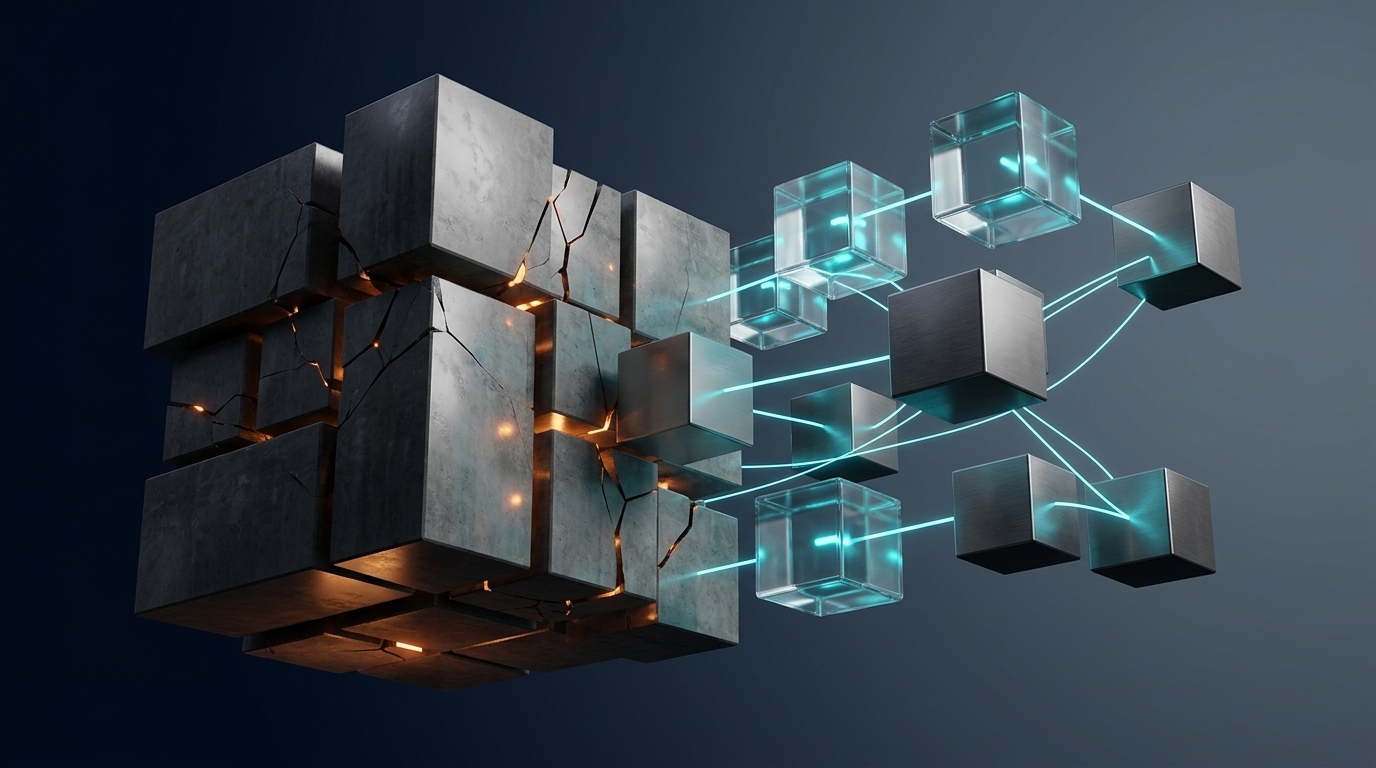
Un despliegue, una base de datos, módulos con fronteras claras por dentro.
Cada caja exige pipeline, monitoreo, API versionada y autenticación propias.
Los costos que llegan desde el primer día
Los costos aparecen porque cada servicio independiente trae consigo una lista de obligaciones que no admite recortes: un proceso de despliegue, monitoreo y alertas, manejo de registros, una API con versiones que mantener y autenticación frente a los demás servicios. Lo que en un monolito es una llamada de función se convierte en una llamada de red, con latencia, con fallas parciales, con reintentos y con la posibilidad de que dos servicios tengan versiones incompatibles de la misma información. Depurar un error deja de ser seguir el código en un solo lugar y pasa a ser reconstruir el recorrido de una petición a través de varios sistemas, lo que exige herramientas de rastreo distribuido que también hay que montar y operar.
En las evaluaciones de sistemas que hacemos, el cuadro típico del microservicio prematuro es un equipo pequeño que dedica una parte creciente de su semana a infraestructura: pipelines, orquestadores, colas de mensajes y tableros de monitoreo para una docena de servicios que atienden el tráfico que un solo proceso serviría sin esfuerzo. Esa dedicación es nómina gastada en operar la arquitectura en lugar de construir producto, y es la parte del costo que no aparece en la factura de la nube, aunque suele superarla.
El desenlace más costoso de una división apresurada tiene nombre propio en la industria, el monolito distribuido, y consiste en servicios separados que comparten base de datos o que deben desplegarse juntos porque sus fronteras se trazaron mal. Esa configuración conserva todos los costos de operar sistemas distribuidos y ninguno de los beneficios de la independencia, y es el resultado más frecuente cuando la división se hace antes de entender dónde están los bordes reales del dominio.
El monolito modular como punto de partida
La alternativa con mejor historial para empresas medianas es un solo sistema desplegable con módulos bien delimitados por dentro, cada dominio del negocio en su módulo, con interfaces claras entre ellos y con su porción del esquema de datos separada. El despliegue es uno, las transacciones son locales, la depuración ocurre en un solo lugar y el equipo completo entiende el sistema completo.
La modularidad interna ordena el presente y deja preparada la extracción futura al mismo tiempo, porque cuando un módulo concreto demuestra con datos que necesita independencia, sea porque su carga creció de forma desproporcionada o porque un equipo dedicado empezó a chocar con el resto, extraerlo es una operación acotada sobre fronteras ya conocidas. Las migraciones de monolito modular a servicios tienen una tasa de éxito muy superior a las divisiones hechas al inicio del proyecto, porque a esa altura la empresa ya sabe dónde pasan las líneas del negocio, información que al arrancar nadie tiene.
Criterios para decidir el momento
Recomendamos tratar la división en servicios como una decisión que se gana con evidencia operativa. Los indicadores que la justifican son observables: varios equipos que se bloquean entre sí en el mismo código, un componente cuya demanda de recursos crece a un ritmo distinto del resto y ya no conviene escalar junto, un dominio que exige disponibilidad o cumplimiento regulatorio aparte, o la madurez previa de automatización, monitoreo y turnos de guardia que operar sistemas distribuidos presupone. Donde esos indicadores no aparecen, la división agrega costo sin contrapartida, y donde aparecen, la extracción del módulo señalado se justifica sola.
La arquitectura termina reflejando la estructura del equipo que la construye, una observación conocida en la industria como ley de Conway. Un equipo pequeño que adopta la arquitectura de una organización de quinientos ingenieros hereda la operación de esa organización sin heredar sus manos. El tamaño del sistema que una empresa puede operar con solvencia lo define su equipo, y la decisión de arquitectura mejor envejecida es la que parte de ese dato y deja que los servicios aparezcan cuando la operación real los pida.
Imágenes generadas con IA